1.Cos'è una Company Brain (e cosa NON è)
Una Company Brain (o second brain aziendale) è un archivio di conoscenza strutturato apposta perché un'AI lo legga e lo navighi: una rete di piccole note collegate che l'AI percorre come una mappa, per rispondere con il tuo contesto. Risolve il fatto che la conoscenza è sparsa in tre posti:
- Nelle chat (Slack, email, file dispersi): si perde, nessuno ricorda dov'è.
- Nella testa delle persone (il "top performer"): se se ne va, un pezzo di azienda esce con lei.
- In mille strumenti (un PDF qui, un Excel là): frammentata e inutilizzabile.
Cosa NON è: non è ChatGPT/Claude "nudo". Se tu e il concorrente usate la stessa AI senza un contesto vostro, ottenete le stesse risposte: zero vantaggio. La Brain dà all'AI ciò che solo tu hai — i tuoi dati.
2.Perché farla ora: i numeri e il vantaggio competitivo
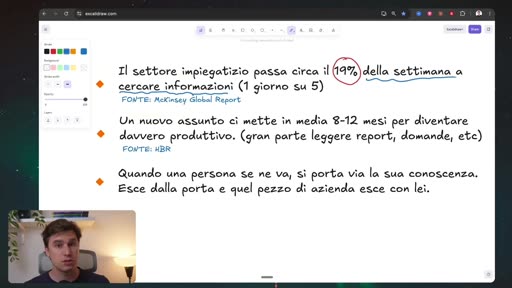
- 19% della settimana se ne va a cercare informazioni (≈1 giorno su 5). McKinsey.
- Un nuovo assunto: 8–12 mesi per diventare produttivo. HBR.
- Chi se ne va porta via la conoscenza: impatto su fatturato, training, tempo.
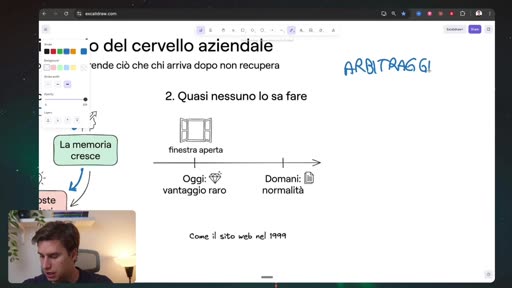
Una Brain che migliora ogni giorno crea un vantaggio cumulativo: l'AI ti conosce sempre meglio e il distacco dai concorrenti cresce.
3.Dizionario minimo
- Obsidian
- App gratuita che mostra una cartella di file di testo (Markdown) come una rete di note collegate. È un layer sopra la cartella: i dati restano file sul tuo computer.
- Markdown (.md)
- Formato di testo semplice, lo standard che le AI digeriscono meglio.
- Wikilink
[[Nota]] - Collegamento da una nota a un'altra: il "filo" che l'AI percorre.
- Backlink
- Il collegamento al contrario: se A punta a B, B "sa" di essere citata da A.
- Front matter (YAML)
- Blocchetto in cima alla nota (tra
---) con titolo, riassunto, tag, link. L'AI lo legge per primo per decidere se la nota serve. - Graph view
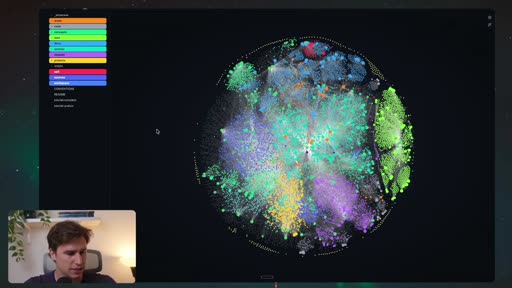
- La vista "a palla" con tutte le note e i collegamenti.
- Claude Code / Cowork
- L'AI che apre la cartella, legge e naviga i file: il "motore" della Brain.
- Canon
- La "bibbia" aziendale: un unico documento con tutti e soli i fatti veri (anti-allucinazione).
- Nota atomica
- Una nota = una sola idea, autonoma (concetto dello Zettelkasten).
- Hub (Map of Content)
- Nota-indice che collega tante note di un'area.
- RAG
- Retrieval-Augmented Generation: ricerca per somiglianza di significato (vettori), utile con migliaia di note.
- Version control
- Storico delle versioni (GitHub/Google Drive): si torna indietro e si condivide un'unica copia.
4.L'architettura a strati (la mappa del sistema)
| Strato | Strumento | A cosa serve |
|---|---|---|
| Layer AI | Obsidian (note .md) | Il cervello: note + collegamenti che l'AI naviga |
| Motore | Claude Code / Cowork | Legge, scrive e naviga le note |
| Qualità | Script Python + _index + llms.txt | Brain pulita, senza orfani, efficiente in token |
| Version control | GitHub / Google Drive | Storico, backup, unica fonte di verità |
| Layer visivo | Notion / HTML | Cruscotto per le persone (team o cliente) |
| Scala | RAG (Qdrant/Supabase/Pinecone) | Ricerca semantica con migliaia di note |
| Memoria viva | skill journal | Registra sessioni e giornate: l'AI "ricorda" |
5.Obsidian: note, wikilink e front matter
Installazione. Scarica Obsidian, crea una cartella (es. Aurora Cervello), poi Open folder as vault. Ogni nota è un file .md.
Collegare due note. Scriverle separate le lascia scollegate. Per collegarle si usano le parentesi quadre:
Il commerciale di riferimento è [[persona-elena-ferraro]].Si crea un wikilink (A→B) e un backlink (B sa di essere citata). Ora l'AI può "diramarsi" verso la persona e prenderne tutto il contesto.
Front matter. L'AI legge prima questo blocco e prosegue solo se è rilevante (meno token, meno allucinazioni):
---
title: Identità di Aurora Sistemi
summary: Hub centrale; SaaS gestione patrimonio immobiliare, Milano 2018.
tags: [self, identita, hub]
type: identita
status: active
related: ["[[persona-elena-ferraro]]", "[[area-finance-operations]]"]
---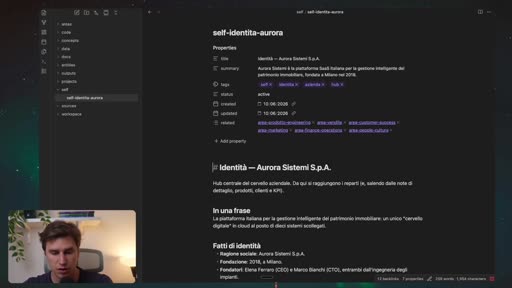
self-identita-aurora con front matter e collegamenti related.Regole d'oro: summary chiaro (è ciò che l'AI legge per prima); primo tag = la cartella; almeno 3 wikilink in related su una sola riga; se il front matter è rosso è "rotto" → chiedi a Claude di sistemarlo.
6.Tassonomia vs Ontologia: le 11 cartelle
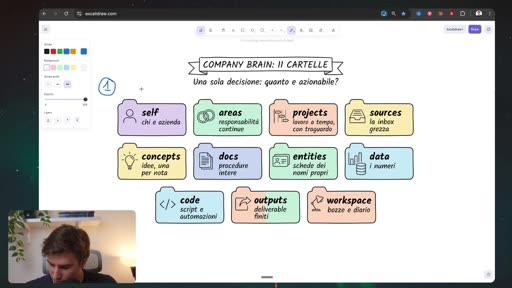
Tassonomia = come archivi (le cartelle). Ontologia = come colleghi (i wikilink). La logica di archiviazione scelta è l'azionabilità. La struttura è agnostica (funziona per ogni business):
| # | Cartella | Cosa contiene |
|---|---|---|
| 1 | self | Chi siamo: identità, missione, visione, offerte, obiettivi. |
| 2 | areas | Responsabilità continue (reparti): sales, marketing… (freelancer: i canali). |
| 3 | projects | Lavori con inizio e fine (one-off). |
| 4 | sources | L'inbox grezza: appunti, articoli. |
| 5 | concepts | Definizioni per l'AI: cos'è "ARR", cos'è "churn". |
| 6 | docs | Le SOP (procedure interne). |
| 7 | entities | Nomi propri: persone, prodotti, fornitori, tool. |
| 8 | data | I numeri in tabella: KPI, report, valori. |
| 9 | code | Script e automazioni ricorrenti. |
| 10 | outputs | Deliverable finiti: proposte, case study, contratti. |
| 11 | workspace | La memoria viva: diario di sessioni e giorni. |
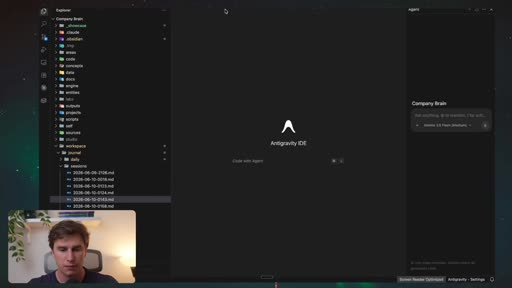
workspace vivono daily e sessions.7.Note atomiche, Canon e Hub
Note atomiche (Zettelkasten). Dal sociologo Niklas Luhmann, che scrisse decine di libri grazie a ~90.000 schede, ognuna con una sola idea collegata alle altre. Per un'azienda: non PDF da 40 pagine, ma note brevi e riutilizzabili → l'AI ha sempre il contesto giusto.
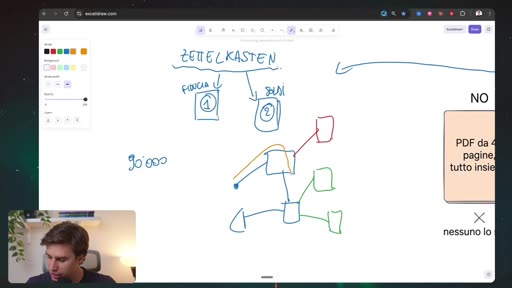
Canon = la bibbia aziendale. Prima di spezzare i dati in note, si crea un Canon con tutti e solo i fatti veri (anti-allucinazione). Metafora: una grande bacinella (il Canon) divisa in 11 bacinelle (le cartelle); la somma deve restare identica.
Hub (Map of Content). Note-indice ben formattate che fanno da centro per ogni area. Senza hub, l'AI crea note che restano orfane. L'hub centrale è self, a cui si agganciano i reparti, e ai reparti il dettaglio.
8.La costruzione passo-passo (con i prompt)
Passo 1 — Crea lo scheletro (11 cartelle vuote).
Creami nel vault, alla radice, queste 11 cartelle vuote — una per ciascun lavoro del
cervello: self, areas, projects, sources, concepts, docs, entities, data, code, outputs,
workspace. Non crearne altre, non metterci file dentro: solo le cartelle.
Passo 2 — Estrai il Canon (prima un piano!).
Sei l'architetto del cervello aziendale di [Azienda]. Leggi tutto il materiale grezzo
nella cartella sources. Estrai i fatti duri e scrivili in un unico Canon coerente che copra:
identità, prodotti, reparti, persone e ruoli, clienti, KPI. Regole: nessun fatto inventato;
se non è in sources non scriverlo; i numeri devono quadrare. Scrivi il Canon in un solo file
di lavoro. Prima di scrivere, dammi in 5 righe cosa hai trovato e come pensi di strutturarlo,
poi aspetta il mio ok.
Usa la plan mode invece di "bypass permission": controlli il piano prima dell'esecuzione.
Passo 3 — Trasforma il Canon in note atomiche (prima gli hub).
Ok il Canon va bene. Trasformalo in note atomiche dentro le 11 cartelle. Regole: una nota =
un concetto, max 300 righe, front matter in cima (title, summary, tags…), "related" su una
sola riga con almeno 3 wikilink, nome unico. Ordine: PRIMA gli hub (self e i reparti in
areas), POI le note di dettaglio (prodotti, clienti, KPI). Mostrami "self-identita" prima
di proseguire.
Passo 4 — Completa il cervello.
Perfetto, ora completa il cervello. (I canali commerciali — LinkedIn, eventi, partner —
creali come TAG, perché un'attività può appartenere a più canali.)9.Qualità: index, gate, llms.txt, showcase
a) _index per non avere note orfane. Una nota senza collegamenti non viene letta dall'AI (che viaggia solo sui link). Metti un _index in ogni cartella, collegato a tutte le note di quella cartella.
b) Quality gate (script Python) che controlla 6 regole e produce un referto:
Crea uno script Python che faccia da gate di qualità sul cervello. Controlla ogni nota
(salta sources/workspace/scratch): 1) front matter completo; 2) max 300 righe; 3) almeno
3 wikilink; 4) zero link rotti; 5) zero orfani; 6) una sola componente connessa. Elenca gli
errori per regola. Se è tutto ok rispondi "OK, 0 errori". Per ora non correggere: solo referto.
Principio di Joe: con l'AI puoi fare outsourcing di competenza e di pensiero, ma non della comprensione.
c) llms.txt — un indice testuale che riassume cosa contiene la Brain (Claude non deve riesplorarla ogni volta → risparmio token). (Raccomandazione pratica, non standard ufficiale.)
d) showcase.md — riassunto delle metriche (note, hub, wikilink): a colpo d'occhio e utile in vendita.
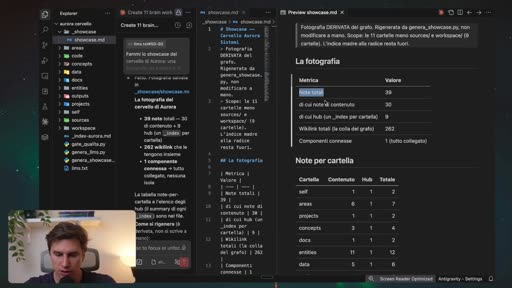
showcase.md: note totali, di contenuto, hub, wikilink, "componente connessa = 1".10.Version control: GitHub / Google Drive
Obsidian è local-first: i dati stanno sul tuo computer (privacy), ma se si rompe perdi tutto. Serve uno storico condiviso: GitHub (tecnico, scala meglio) o Google Drive (semplice).
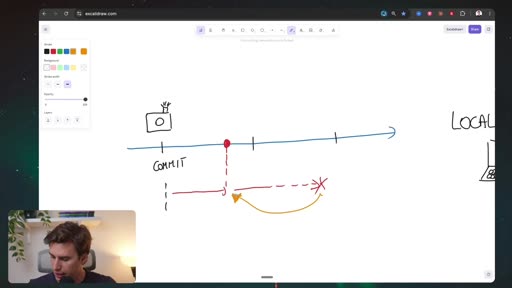
- commit = una "fotografia" del progetto (checkpoint a cui tornare).
- branch = ramo parallelo per provare modifiche grosse senza toccare il
main; se funziona fai merge, se no cancelli.
GDPR: con i servizi cloud (Notion, database RAG) firma i DPA per gestire i dati a norma.
11.Layer visivo: Notion e HTML
La Brain è usata soprattutto dall'AI; alle persone serve un'interfaccia.
HTML — cruscotto statico, doppio clic, senza account:
Genera un cruscotto HTML statico dai dati del Canon: indicatori dell'ultimo mese, grafici,
andamento, classifica. Tutto in un solo file HTML, offline e senza account.
Notion — per i team; si collega via MCP (un connettore che dà a Claude accesso a Notion):
/mcp  → aggiungi il server Notion → autentica → riavvia il workspace
Poi: "Costruiscimi su Notion un cruscotto KPI per Aurora (clienti, revenue…). Chiamalo 'Cervello Pino'."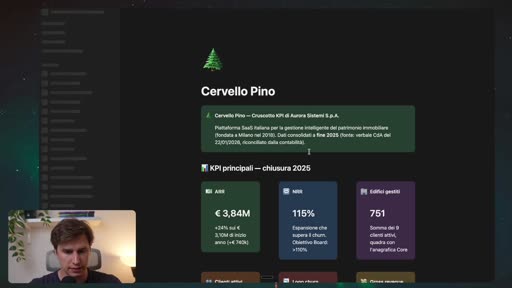
Si può chiedere all'AI di sincronizzare Notion ↔ Obsidian (il "brain sync"). Esempio di verifica:
Rispondi usando SOLO le note del cervello; cita il file; se non c'è, scrivi "non presente
nel cervello". Domanda: quali clienti hanno attivato sia Aurora Cloud, e chi li segue nel
Customer Success?
La Brain cita i file, dice cosa non sa, e incrociando entità/prodotti/KPI risponde anche a "quale impiegato porta più ARR?" o "quali dati mancano per un'analisi completa?".
12.Memoria viva: la skill "journal"
Finora la memoria è statica. Per chiedere "a marzo cosa avevamo deciso col cliente X?" serve una memoria dinamica: una skill journal con tre comandi, nella cartella workspace:
- buongiorno / inizio sessione → legge l'indice e dà un briefing di 5 righe (non scrive).
- fine sessione → salva il riassunto della conversazione (note granulari, con wikilink).
- fine giornata → consolida le sessioni in un daily + pending topics + next step; recupera sessioni orfane, verifica GitHub, fa il sync finale.
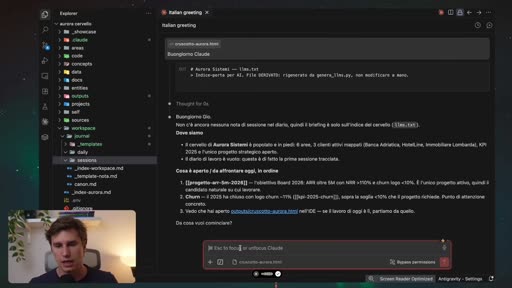
Perché due livelli? Le sessioni sono granulari (ottime per il RAG); i daily sono riassunti. L'AI trova in fretta "la giornata giusta" e poi scende nel dettaglio.
13.Scalare: quando serve il RAG
Con poche note Claude naviga benissimo sui wikilink. Oltre una soglia conviene il RAG: le parole diventano vettori e si cercano quelli "vicini" alla domanda (meno token).
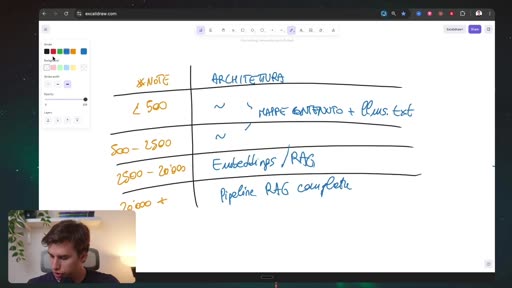
| N. note | Architettura consigliata |
|---|---|
| < 500 | Mappe di contenuto (hub) + llms.txt. Basta Obsidian + Claude. |
| 500 – 2.500 | Come sopra; inizi a valutare gli embeddings. |
| 2.500 – 20.000 | Embeddings + RAG. |
| 20.000+ | Pipeline RAG completa. |
Database RAG: Qdrant (specializzato), Supabase (anche version control dei dati), Pinecone, Weaviate. È un mondo a sé (embedding, chunking, ricerca vettoriale).
14.Checklist finale + errori da evitare
Checklist di costruzione
- Installa Obsidian → crea il vault.
- Crea le 11 cartelle (Passo 1).
- Estrai il Canon con piano e regole anti-allucinazione (Passo 2).
- Crea hub e note atomiche con front matter corretto (Passo 3–4).
- Aggiungi
_indexin ogni cartella. - Lancia il quality gate finché → "OK, 0 errori".
- Aggiungi
llms.txteshowcase.md. - Collega GitHub/Google Drive.
- Aggiungi il layer visivo (Notion via MCP e/o HTML).
- Costruisci la skill
journal(memoria viva). - Quando cresci → introduci il RAG.
Errori da evitare
- Note orfane (senza link): l'AI non le vede → usa
_index. - Mappazzoni PDF invece di note atomiche → l'AI si perde e allucina.
- Front matter rotto (rosso) → chiedi a Claude di sistemarlo.
- Saltare il Canon → senza fonte di verità l'AI inventa.
- Dare i dati prima della struttura → serve prima lo scheletro (11 cartelle + hub).
- Confondere tassonomia e ontologia → servono entrambe.
- Credere che basti "usare l'AI" → senza i tuoi dati hai le stesse risposte dei concorrenti.